01 · A
问题
求职工作流混合了不可信网页、个人文档、模型输出与长任务。仅靠聊天的架构会隐藏失败状态、来源与会产生后果的写入。
先建立可靠工作流,再扩展 Agent
一个处理结构化职位数据、简历摄取与可观察后台任务的类型化 monorepo,并明确划分安全与授权边界。
三行摘要
01 · A
求职工作流混合了不可信网页、个人文档、模型输出与长任务。仅靠聊天的架构会隐藏失败状态、来源与会产生后果的写入。
01 · B
当前平台把 TypeScript monorepo 划分为 Next.js Web、tRPC/Zod 契约、Prisma 持久化、BullMQ/Redis worker 与隔离 crawler 服务。
我用这张流程示意图把任务状态、URL 检查、简历版本和提交前审查门集中呈现。
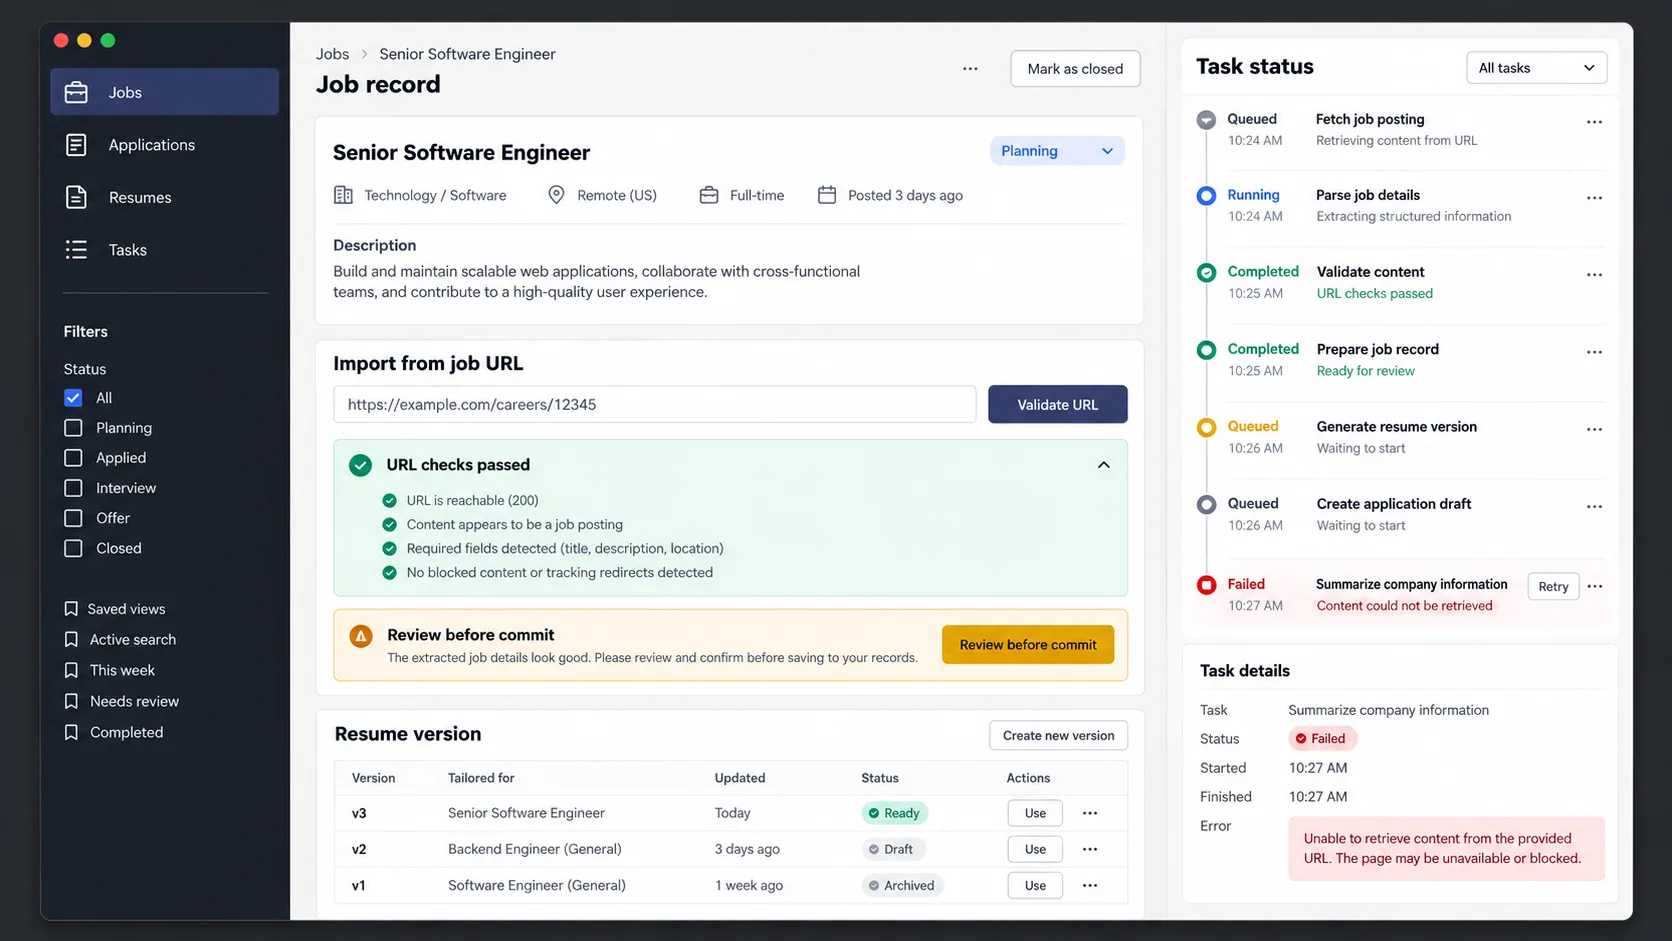
求职数据具有隐私性,申请状态变更会产生真实后果。类型化契约、持久任务状态与显式授权能让失败可诊断,并防止助手悄然越过用户意图。
公开 URL 导入必须拒绝不安全协议、内网目标、危险重定向与超大响应。
模型生成的职位数据必须通过 schema 才能持久化。
长任务需要持久状态与显式失败报告。
当前开发身份与 SQLite 持久化不等于生产认证或生产存储。
不可信 URL 边界
每一次重定向和解析后的目标都必须满足网络与资源限制,内容才能进入结构化记录。
把页面与重定向都视为不可信输入
拒绝不安全协议与内网目标
逐跳复核、超时和响应体大小
Provider 输出必须通过 Zod
人工确认后进入业务状态
系统路径
通过受控接口导入职位网页与上传简历
数据进入业务状态前执行 tRPC/Zod 契约
运行 crawler 与 BullMQ worker,并持久化 TaskRun 状态
呈现可编辑记录、申请状态与显式失败
持久任务生命周期
持久状态让 Web 应用即使面对另一个进程中的 worker,也能解释等待、进度与失败。
工作开始前任务记录已经存在
Worker 领取任务并报告进度
经校验结果绑定到记录
失败原因保持可查询
受控决策启动下一次尝试
关键取舍
队列消息负责触发工作,TaskRun 保留可查询的排队、运行、完成或失败状态。
Crawler 把不可信网络访问放在主进程之外,并校验重定向与资源上限。
Provider 输出只有通过 schema 后才能成为应用数据;模型回答不等于数据库记录。
04 · A
04 · B
01Agent 产品从可验证状态、有限权限与确定性写入开始,而不是从更多工具开始。
02只有当状态、重试与失败可观察时,异步架构的复杂度才值得。
我能公开的内容
我围绕 monorepo 边界、数据流、结构化职位提取、受控 URL 抓取与异步简历处理开发这一平台。它目前是原型:身份与 SQLite 持久化仍面向开发,部分 Agent/RAG processor 仍在完善中。
公开来源