01 · A
Problem
Karriereabläufe verbinden nicht vertrauenswürdige Webseiten, persönliche Dokumente, Modellausgaben und lange Tasks. Eine reine Chat-Architektur würde Fehler, Herkunft und folgenreiche Schreibvorgänge verdecken.
Verlässlicher Workflow vor autonomem Agenten
Ein typisiertes Monorepo für strukturierte Stellendaten, Lebenslauf-Ingestion und beobachtbare Hintergrundarbeit mit klaren Sicherheits- und Berechtigungsgrenzen.
Kurzfassung
01 · A
Karriereabläufe verbinden nicht vertrauenswürdige Webseiten, persönliche Dokumente, Modellausgaben und lange Tasks. Eine reine Chat-Architektur würde Fehler, Herkunft und folgenreiche Schreibvorgänge verdecken.
01 · B
Die aktuelle Plattform teilt ein TypeScript-Monorepo in Next.js-Webanwendung, tRPC/Zod-Verträge, Prisma-Persistenz, BullMQ/Redis-Worker und isolierten Crawler.
Mit dieser Ablaufillustration mache ich Taskzustand, URL-Prüfungen, Lebenslaufversionen und das Review-vor-Commit-Gate an einem Ort nachvollziehbar.
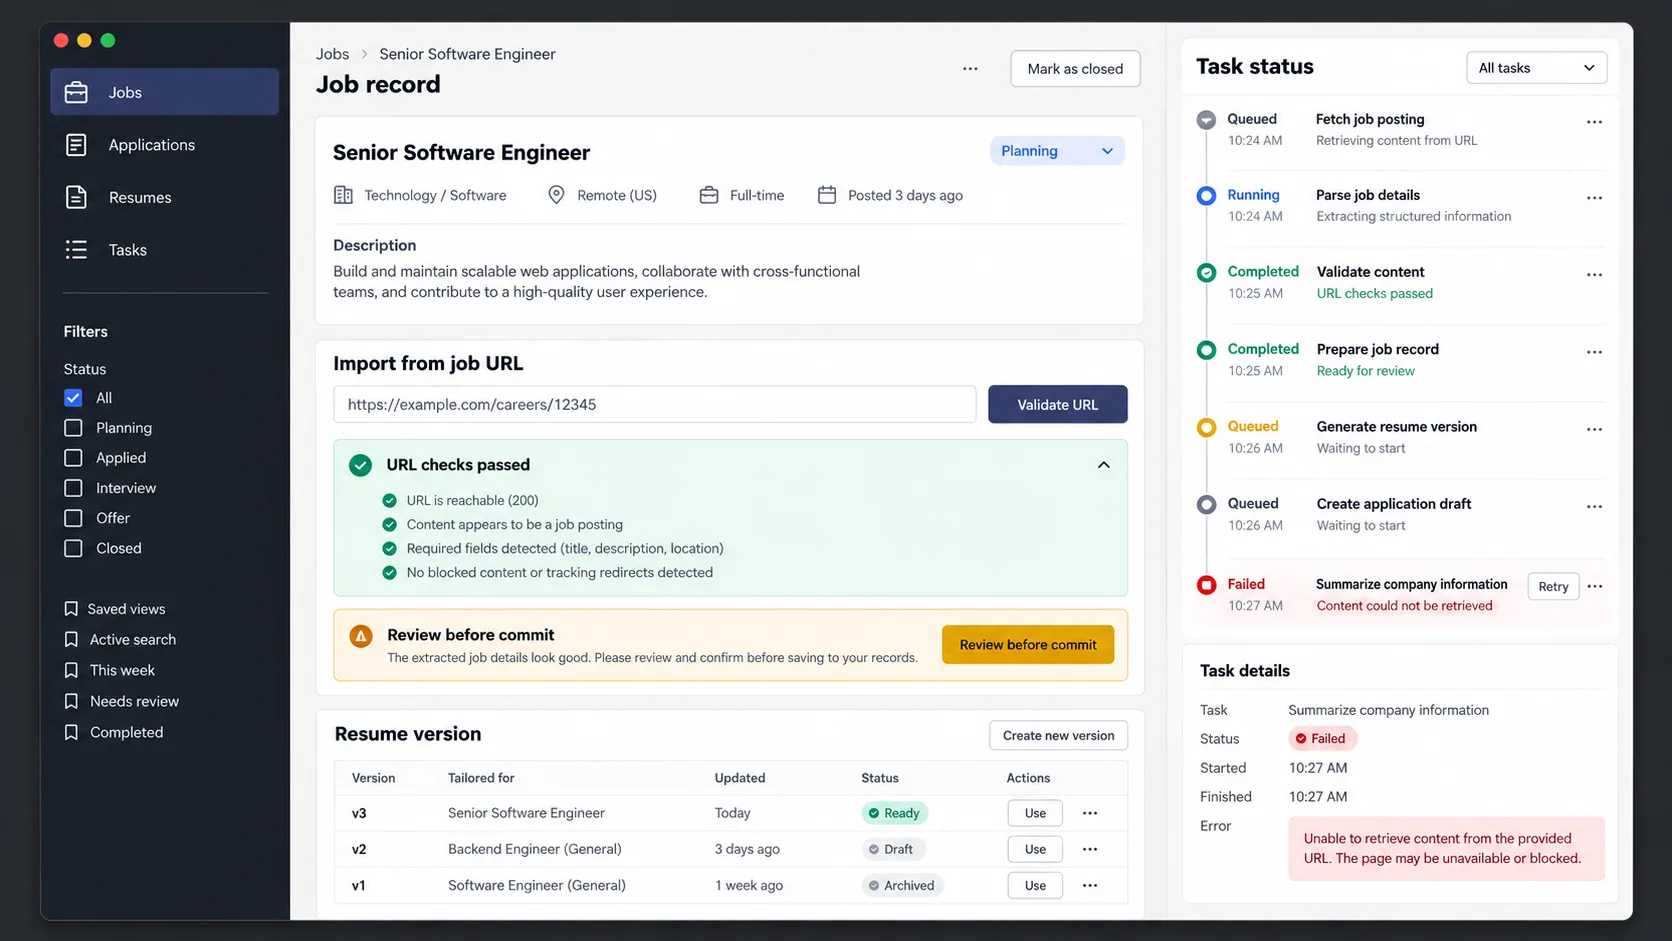
Karrieredaten sind persönlich und Statusänderungen folgenreich. Typisierte Verträge, dauerhafter Taskstatus und explizite Autorisierung machen Fehler diagnostizierbar und begrenzen den Assistenten auf die Nutzerabsicht.
URL-Importe müssen unsichere Protokolle, interne Ziele, Redirects und übergroße Antworten ablehnen.
Modellgenerierte Stellendaten müssen vor Persistenz ein Schema erfüllen.
Lange Aufgaben brauchen dauerhaften Zustand und klare Fehlerberichte.
Entwicklungsidentität und SQLite sind keine Produktionsauthentifizierung oder -speicherung.
Grenze für nicht vertrauenswürdige URLs
Jeder Redirect und jedes aufgelöste Ziel muss Netzwerk- und Ressourcengrenzen erfüllen, bevor Inhalte zu einem strukturierten Datensatz werden.
Seite und Redirects als untrusted behandeln
Unsichere Protokolle und interne Ziele ablehnen
Hops, Timeout und Größe erneut prüfen
Provider-Ausgabe muss Zod erfüllen
Bestätigte Daten werden Geschäftszustand
Systempfad
Stellenseiten und Lebensläufe über begrenzte Schnittstellen importieren
tRPC/Zod-Verträge vor Übernahme in den Geschäftszustand anwenden
Crawler und BullMQ-Worker mit persistentem TaskRun-Status ausführen
Editierbare Datensätze, Bewerbungsstatus und Fehler sichtbar machen
Dauerhafter Task-Lebenszyklus
Persistierter Status lässt die Webanwendung Warten, Fortschritt und Fehler erklären, auch wenn der Worker in einem anderen Prozess läuft.
Taskdatensatz existiert vor Arbeitsbeginn
Worker übernimmt und meldet Fortschritt
Validiertes Ergebnis wird angehängt
Fehlergrund bleibt abfragbar
Kontrollierte Entscheidung startet neuen Versuch
Zentrale Abwägungen
Queue-Nachrichten starten Arbeit; TaskRun bleibt der abfragbare Statusdatensatz.
Crawler-Kontrollen halten untrusted Fetching aus dem Hauptprozess und prüfen Grenzen.
Provider-Ausgaben werden erst nach Schemavalidierung zu Anwendungsdaten.
04 · A
04 · B
01Agentenprodukte beginnen mit prüfbarem Zustand, begrenzter Autorität und deterministischen Schreibvorgängen—nicht mit mehr Tools.
02Asynchrone Architektur lohnt sich nur bei sichtbaren Zuständen, Wiederholungen und Fehlern.
Was ich öffentlich teilen kann
Ich entwickle diese Plattform rund um Monorepo-Grenzen, Datenflüsse, strukturierte Stellenextraktion, kontrollierten URL-Abruf und asynchrone Lebenslaufverarbeitung. Sie ist ein Prototyp: Identität und SQLite-Persistenz sind entwicklungsorientiert, mehrere Agent/RAG-Prozessoren sind noch in Arbeit.
Öffentliche Quellen