01 · A
问题
企业手册篇幅长、术语密集,信息分散在不同章节。只有系统找到了正确证据且用户能够检查时,流畅回答才真正有用。
从用户需求到原型与评估
一项 Design Science 论文研究,把技术手册问答转化为带来源的本地 RAG 原型,并分别设计检索与回答评估。
三行摘要
01 · A
企业手册篇幅长、术语密集,信息分散在不同章节。只有系统找到了正确证据且用户能够检查时,流畅回答才真正有用。
01 · B
我采用 Design Science 研究流程,覆盖用户需求、系统架构、本地检索生成原型、技术评估与用户反馈。
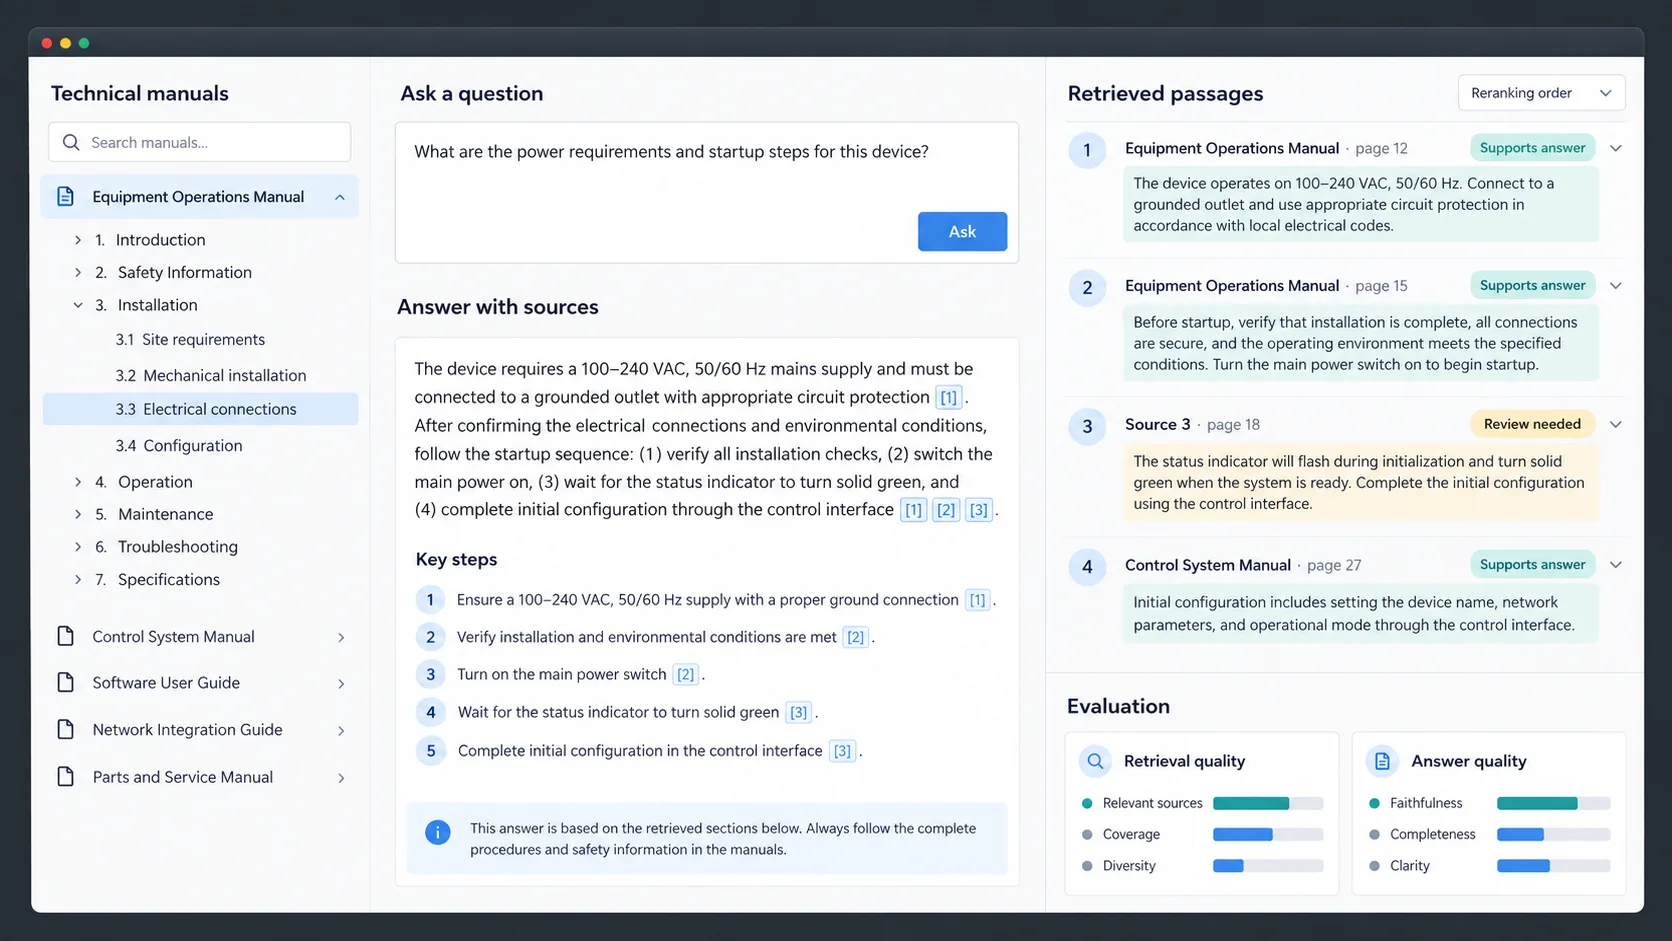
我用这张流程示意图呈现带引用回答与排序来源片段并列的工作流,并将检索质量与回答质量分开考察。
一次漂亮演示不能证明企业知识系统有效。检索相关性、回答支持度与用户信任是不同问题,需要不同证据。
用户语言与手册术语不总是一致。
向量相似度高不代表片段足以回答问题。
检索质量与回答质量需要分开评估。
领域 benchmark 需要专家定义问题与相关来源。
系统路径
把用户需求转化为检索、引用与本地部署要求
组合本地 embedding、词法信号与 reranking
基于选定片段生成,并保留来源追溯
把技术检索/回答检查与访谈反馈分开
带来源的回答链路
原型先收集并重排支持材料,再基于选定片段生成回答,同时保留来源身份。
自然语言与手册术语可能不同
词法与本地 embedding 候选
针对具体问题重新排列片段
只基于选定上下文生成
暴露支持章节供用户检查
关键取舍
Design Science 让原型围绕用户任务,而不是围绕某个偏好的模型。
找错资料,与从正确资料中回答失败,应被分别观察。
系统不能自己出题,再把这套题当作独立有效性证据。
04 · A
04 · B
评估设计
分离两层评估才能定位失败,也避免一个总分掩盖系统究竟在哪一层出错。
系统是否找到专家认定的相关材料?
回答是否有支持、完整且适合问题?
工作流是否易理解且对任务有帮助?
为保护保密的论文材料,我不在此公开参与人数或详细指标。
01RAG 是一组围绕来源、失败类型与信任的系统决策,而不只是向量数据库。
02用户反馈可以解释体验,但不能替代技术检索证据。
我能公开的内容
企业手册、项目仓库与用户研究材料属于保密内容,因此不能公开。我可以介绍研究设计、本地 RAG 架构与评估方法;具体参与者和 benchmark 数字保持私密。
公开来源