01 · A
Problem
Die Dimension eines vollständigen Layouts ändert sich mit Brückenlänge und Pfeilerzahl. Das Projekt formuliert die Planung als Folge von Spannweitenentscheidungen und entfernt unmögliche Aktionen vor der Auswahl.
Beschränkte sequenzielle Entscheidungen
Ein gemeinsames Brückenlayout-Modell mit erklärbaren Kosten, klassischen Baselines und maskierten RL-Solvern für variable Brückenlängen.
Kurzfassung
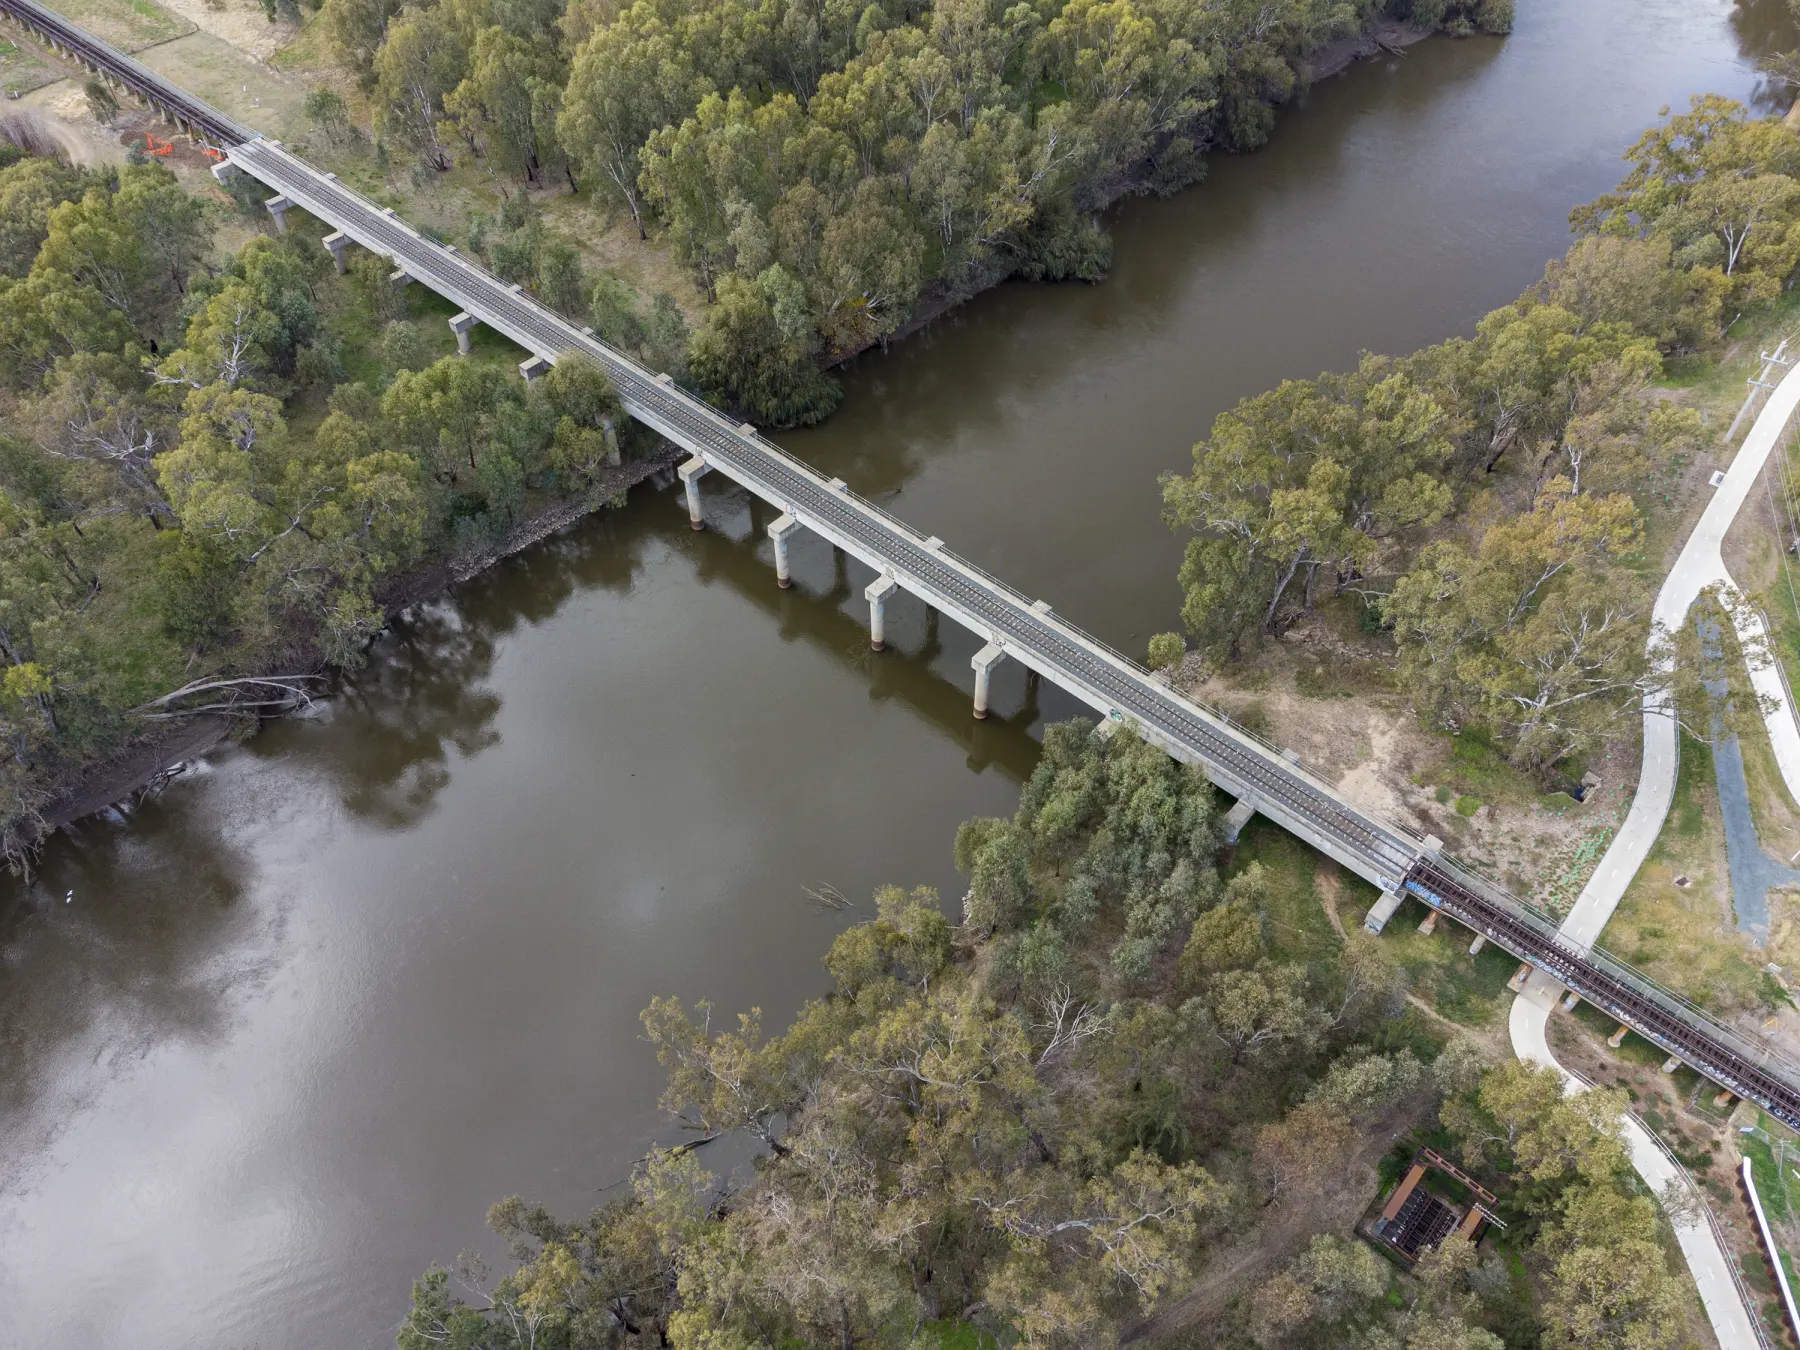
01 · A
Die Dimension eines vollständigen Layouts ändert sich mit Brückenlänge und Pfeilerzahl. Das Projekt formuliert die Planung als Folge von Spannweitenentscheidungen und entfernt unmögliche Aktionen vor der Auswahl.
01 · B
Random, kostenbewusstes Greedy, begrenztes Beam-DP, tabellarische Verfahren und DQN nutzen dasselbe Domänenmodell; Offline-Training ist für HPC/Slurm vorgesehen.
Brückenlayouts verbinden harte Ausschlusszonen mit konkurrierenden, verlaufsabhängigen Kosten. Gemeinsame Randbedingungen und erklärbare Baselines machen ungültige Vorschläge sichtbar, zertifizieren aber keinen Entwurf.
Brückentyp, Länge, Spannweitenkatalog und Auflösung verändern den Suchraum.
Flüsse, Straßen und weitere Regionen werden zu Ausschlüssen oder abgestuften Kosten.
Das vollständige Ziel ist verlaufsabhängig; Beam-DP ist nicht allgemein exakt.
Illegale Aktionen müssen bei Exploration und Bellman-Zielen maskiert werden.
Problemreformulierung
Die sequenzielle Formulierung hält ein stabiles Aktionsvokabular: nächste legale Spannweite wählen oder Episode beenden.
Größe ändert sich mit Pfeilern und Länge
Lange feingranulare Entscheidungsketten
Stabiler diskreter Katalog
Horizont ändert sich, Vertrag bleibt
Systempfad
Problem, Zonen, legale Spannweiten und Kostenzerlegung kodieren
Random, Greedy und begrenztes Beam-DP über einen Vertrag ausführen
Tabellarische Verfahren und DQN mit Replay, Target-Netz und Masken trainieren
Versionierte Policies auf zurückgehaltenen Problemverzeichnissen vergleichen
Maskierter Entscheidungsschritt
Die Maske wird aus Position, Restlänge, Spannweitenkatalog und Ausschlusszonen abgeleitet und für Exploration sowie Bellman-Ziele genutzt.
Problem, Position und Spannweitenverlauf
Diskrete Spannweiten plus Ende
Ausschlüsse und unmöglichen Rest entfernen
Greedy, Beam-DP, tabellarisches RL oder DQN
Spannweite anhängen und Kosten zerlegen
Zentrale Abwägungen
Die nächste Spannweite hält das Aktionsvokabular stabil; die Brückenlänge ändert den Horizont.
Begrenztes Beam-DP liefert eine starke erklärbare Referenz; RL untersucht amortisierte Inferenz.
Illegale Aktionen werden vor Auswahl und Bootstrap entfernt.
04 · A
04 · B
01Eine gelernte Policy ist nur mit identischen Randbedingungen und Kosten sinnvoll vergleichbar.
02Schnelle Inferenz ist ein Trade-off, kein Beleg für ein besseres oder sichereres Layout.
Was ich öffentlich teilen kann
Ich implementierte ein gemeinsames Modell, Solverfamilien, Masken, einen DQN-Replay/Target-Netz-Pfad und versionierte Artefakte. Der aktuelle Solver nutzt DQN statt Double DQN; frühere Benchmark-Zahlen lasse ich weg, weil ihr Evaluationssetup unvollständig ist.
Öffentliche Quellen